ByteDance zeigt eine neue KI für flüssige Gespräche
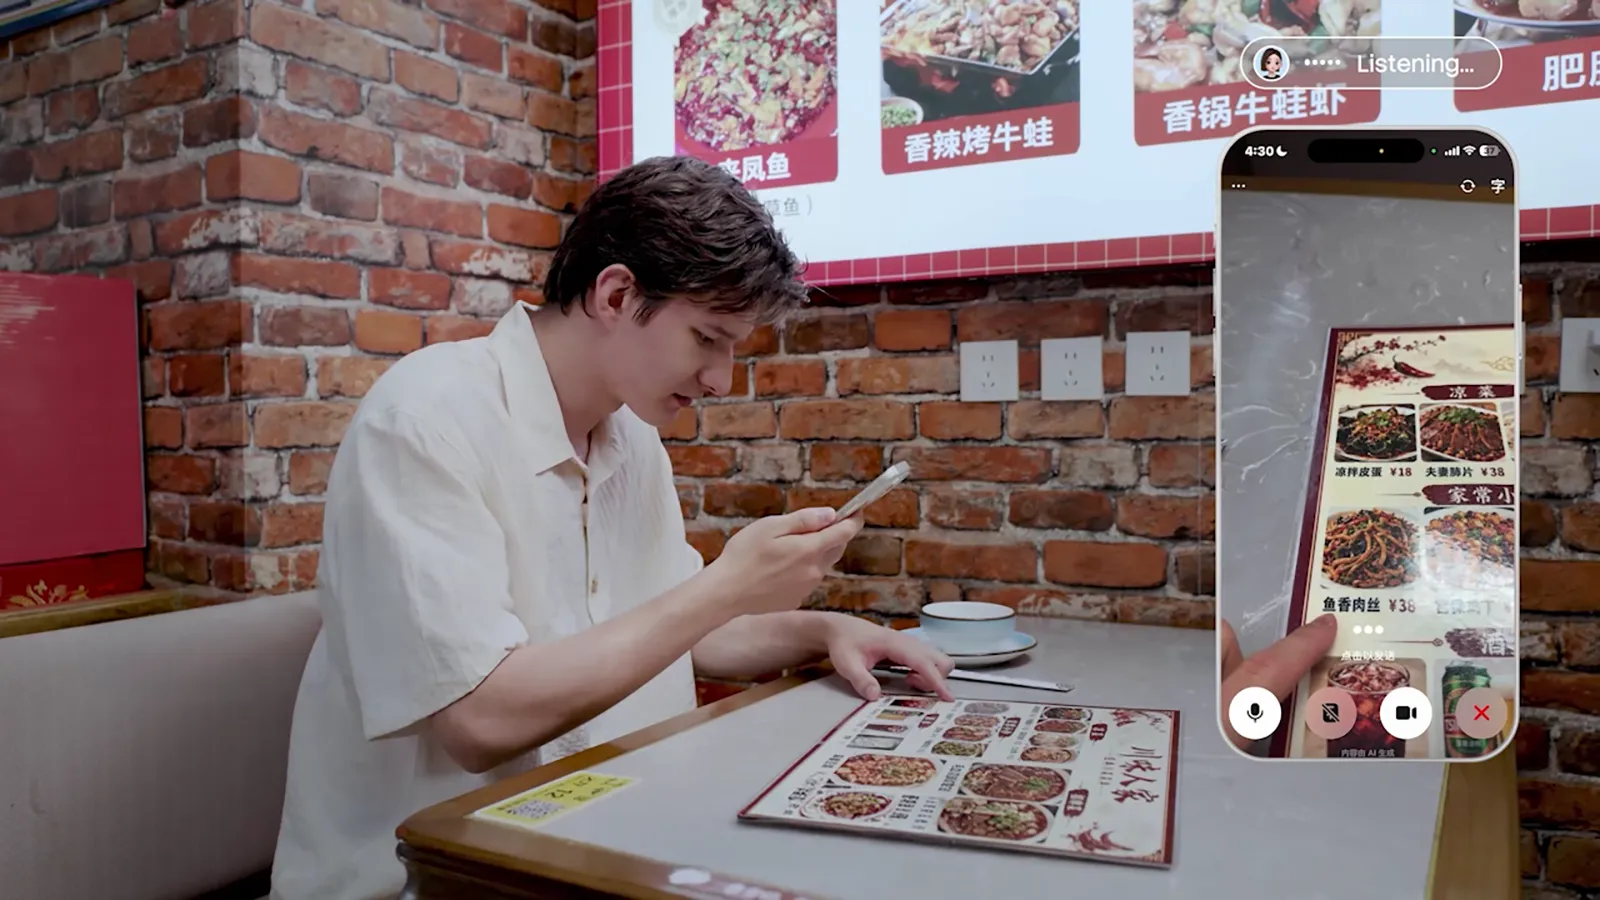
ByteDance hat mit SeedRealtime ein neues KI Modell vorgestellt, das Audio, Video und Text ohne Zeitverzögerung in einer einzigen Architektur verarbeitet. Das System kann dadurch gleichzeitig sehen, hören und sprechen und soll flüssigere Gespräche ohne störende Pausen ermöglichen.
SeedRealtime erkennt Gesprächsrhythmen selbstständig und analysiert Sprecher, Pausen sowie Hintergrundgeräusche, um den passenden Moment für eine Antwort zu finden. Auch Bildinformationen werden direkt einbezogen, etwa um unklare Aussagen mit der passenden Geste im Kamerabild zu verbinden.
In Demonstrationen reagierte das Modell teils proaktiv und korrigierte Nutzer bei der Bedienung einer Espressomaschine. Nach Angaben von ByteDance funktioniert es auch in lauten Umgebungen wie Flughäfen oder Restaurants zuverlässig. In Tests seien Rhythmusprobleme im Gespräch im Vergleich zu älteren Architekturen um die Hälfte reduziert worden.